用 Cloudflare 把 www 301 到裸域:一条规则搞定,附验证方法
把 www.myybk.cn 全部 301 到 https://myybk.cn,我只用了 Cloudflare 自带的 Redirect Rules,没写一行 Worker 代码。过程比想象中简单,但有几个细节值得记一下,尤其是目标 URL「静态还是动态」的选择——选错了不会报错,但内链会全部跳回首页。
为什么要做这件事
同一站点如果能通过多个主机名访问,搜索引擎会把它们当作重复内容分别抓取,权重被稀释。统一入口是 SEO 的基本功:选定一个主域(我选裸域 myybk.cn),其余全部 301 过去。
为什么是 301 不是 302:301 是永久跳转,搜索引擎会把原地址的权重传递给目标地址,并在索引中替换掉原 URL;302 是临时跳转,索引里保留原地址,权重不传递。域名统一是永久决定,用 301。配错成 302 不会报错,但半年后你会发现 www 域还挂在索引里,和裸域抢排名。
为什么选裸域而不是 www:纯粹是偏好——裸域短,念起来顺口,印在名片上也干净。技术上两者没有优劣,重要的是选定一个并坚持到底,所有内链、sitemap、canonical 都用同一个。历史上选 www 有个理由是可以自由 CNAME,但在 Cloudflare 的 CNAME 扁平化面前这个理由已经不成立了。
为什么不用 Page Rules 或 Worker:Page Rules 是 Cloudflare 的老功能,官方已明确用 Rules 套件(Redirect Rules、Cache Rules 等)逐步替代它,新站没必要再去配一个将来要迁移的东西。Worker 当然也能做,但为了一个跳转去维护代码、占用免费额度请求数,属于杀鸡用牛刀。Redirect Rules 免费版就有 10 条额度,做一个 www 统一绰绰有余。
配置过程
路径:Cloudflare 控制台 → 选择你的域名 → Rules → Overview,页面里就有「Redirect from WWW to root」的模板入口,点 Create from template。
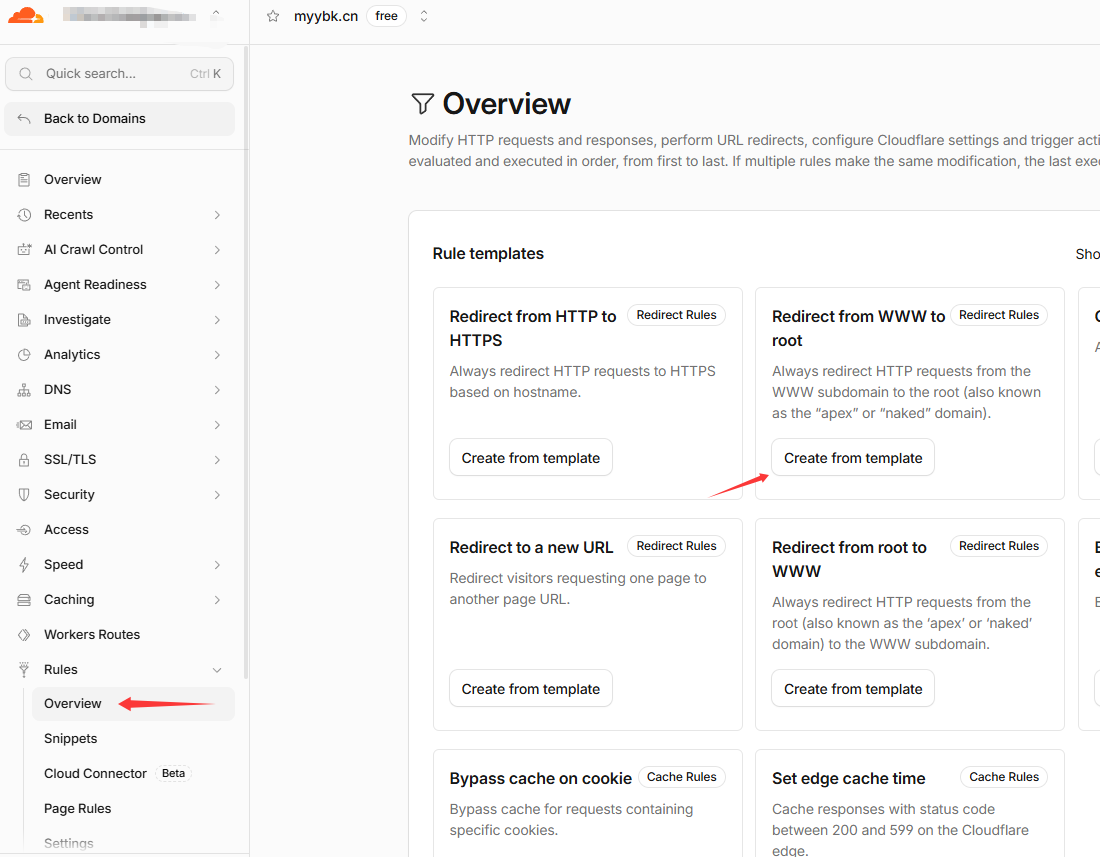
进入模板页后,Cloudflare 已经把一切都填好了:
- 匹配方式:通配符模式,请求 URL 为
https://www.*——星号匹配 www 域名下的任意路径; - 目标 URL:
https://${1}——${1}是通配符替换,会把星号匹配到的路径原样拼到裸域后面; - 状态代码:301 - Permanent Redirect。
不需要修改匹配条件和目标 URL,但建议先勾选底部的「保留查询字符串」再点部署——模板里这个选项默认是未勾选的,不勾的话跳转时 ?utm_source=xxx 这类参数会丢,影响流量统计的归因。
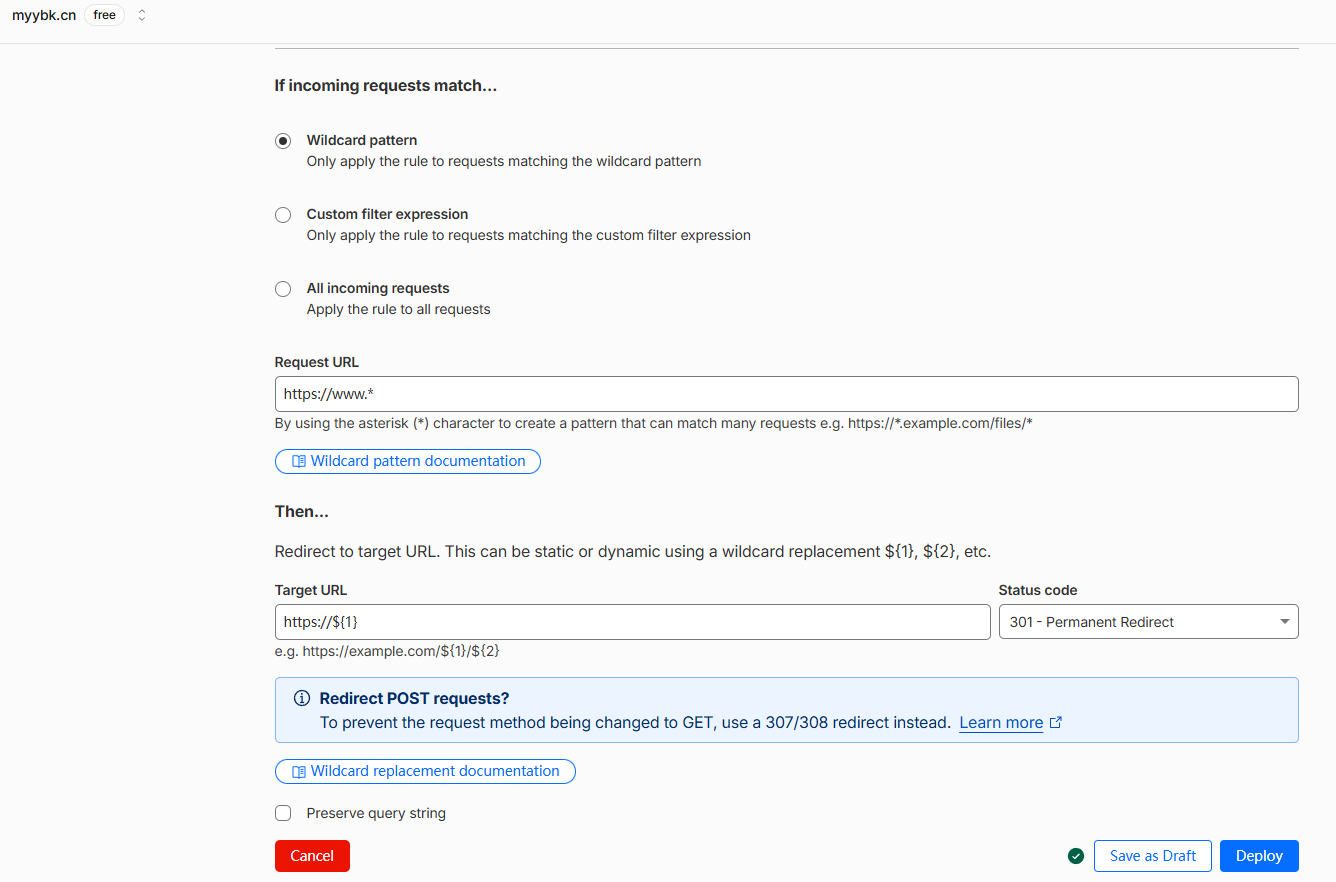
部署后规则立刻生效,不需要等 DNS 传播——因为它工作在 Cloudflare 的边缘节点上,请求还没回源就被 301 拦下来了。
静态目标和动态目标:最容易配错的一个地方
模板部署完我没有马上收工,因为 Redirect Rules 里有一个地方配错了不会报错,但后果很隐蔽——目标 URL 是静态还是动态。
以上面的模板为例,目标 URL 这一栏「可以是静态或动态的」(界面上有原话):
- 静态:填一个固定地址
https://myybk.cn,它会原样写进Location响应头。那所有请求——不管原来是/blog/a还是/about——都会跳到裸域首页,原路径直接丢掉。 - 动态:用
${1}、${2}这样的通配符替换(对应匹配模式里的星号),路径会被原样保留。www.myybk.cn/blog/a会精确跳到myybk.cn/blog/a。如果改用「自定义筛选表达式」模式,动态目标则是写表达式,比如concat("https://myybk.cn", http.request.uri.path),效果一样。
两者的区别对 SEO 是实打实的:带路径的 301 才能把原页面的权重传到对应的新页面,全部跳首页等于把内页的权重白白扔在路上。而且这个错误很隐蔽——只测根路径的话两种配置表现一模一样,都是 301,不带路径的内链测试才能暴露问题。
官方模板预填的 https://${1} 就是保留路径的动态写法,这也是我建议直接用模板而不是手搓规则的原因:手搓时很容易顺手填个静态的裸域地址,测一下首页跳转正常就收工了。
至于 Cloudflare Pages 自动分配的 pages.dev 默认域名,官方建议绑定自定义域名后保留即可,它不会出现在 sitemap 里;确认页面 <head> 的 canonical 都指向主域(我的模板里已统一),搜索引擎自然会以主域为准。
验证方法
浏览器测试不可靠——它会缓存 301,还有 HSTS 记忆,你看到的跳转可能是几个月前的结果。用命令行看真实的状态码:
curl -sI https://www.myybk.cn/blog/some-post/ | grep -E "HTTP|location"预期输出:
HTTP/2 301
location: https://myybk.cn/blog/some-post/
要测三种情况:
- 根路径:
https://www.myybk.cn/应跳到https://myybk.cn/; - 带路径:像上面的例子,location 里路径必须完整保留;
- 带 query 参数:
https://www.myybk.cn/blog/a/?x=1,location 里?x=1不能丢。
三种都 301 且 location 正确,规则才算配好。顺手再用 curl -sIL 跟一次完整链路,确认没有跳转链(比如 http www → https www → https 裸域 这种两跳),每多一跳都损耗权重和速度;理想状态是任何一种入口都一跳直达最终地址。最后在 Search Console 的网址检查里抓几个主域页面,确认抓取正常、canonical 无冲突,这件事就算闭环。