新站 SEO 技术体检实录:一个 Python 脚本跑 12 项检查,在构建产物里抓出 2 个真问题
网上讲 SEO 的文章大多停在「要有 sitemap」「要有 canonical」「图片要加 alt」这个层面——每一条都对,但看完你还是不知道自己的站到底有没有问题。这篇文章换个方式:我直接写了一个 Python 脚本,对着自己博客的构建产物(dist 目录,即真实部署上线的那些文件)跑了一遍 12 项检查,把「觉得没问题」变成「用数据确认没问题」。
结果有点打脸:自以为配置齐全的站,17 个页面里抓出 2 个实打实的问题——sitemap 里 lastmod 条目数为 0,og:image 覆盖率 0/17。这篇文章记录完整过程:脚本怎么写、怎么跑、问题怎么修、修完怎么验证。所有命令和代码都在 Windows 11 + Astro 5 环境下实测通过,可以照抄复现。
一、为什么体检要对构建产物跑,而不是对源码跑
这是整篇文章最重要的一个判断,先说清楚。
源码和线上产物之间隔着一个构建过程,而构建过程会「偷偷」做很多事:布局组件会给每个页面注入统一的 <head>,集成插件会生成 sitemap 和 robots.txt,public 目录的文件会被原样复制,Markdown 会被渲染成 HTML。这意味着:
- 你在 Markdown 里写的图片路径,构建后可能被改写;
- 你以为加了 og 标签,但布局组件里可能根本没输出 og:image;
- 你以为 sitemap 插件开箱即用,但它生成的内容可能和你想的不一样。
源码里看到的是「意图」,产物里才是「事实」。 搜索引擎、分享卡片抓取器看到的都是产物,所以体检也必须对产物做。Astro 项目构建后所有东西都在 dist/ 目录里,纯静态文件,不需要起服务器,离线就能查——这正是静态站做这类检查的天然优势。
二、体检脚本:零依赖 Python,12 项检查
脚本只用 Python 标准库(html.parser、os、re),不装任何第三方包,Windows 上直接跑。检查项一览:
| # | 检查项 | 为什么重要 |
|---|---|---|
| 1 | 每个页面有唯一 title,长度 ≤60 字符 | 重复 title 让搜索结果互相内耗 |
| 2 | 每个页面有 meta description 且不重复 | 影响搜索结果摘要展示 |
| 3 | canonical 标签存在且指向本站正式域名 | 防 URL 变体分散权重 |
| 4 | 每个页面有且仅有一个 h1 | 页面主标题语义唯一 |
| 5 | og:image 存在且文件真实存在 | 社交分享卡片;指向 404 的 og:image 是「维护粗糙」的信号 |
| 6 | 所有 <img> 有非空 alt | 可访问性 + 图片搜索 |
| 7 | 所有 <img> 引用的文件存在 | 批量图片 404 = 站点未完工的观感 |
| 8 | 全站去重内链无死链 | 死链直接影响抓取和体验 |
| 9 | 正文可见文本长度(排除 script/style) | 找出「薄页面」 |
| 10 | 404 页有基本说明文字和回站链接 | 404 页也是一个「页面」 |
| 11 | sitemap URL 与实际页面一一对应 | 多报、漏报都说明构建或配置有偏差 |
| 12 | sitemap 的 lastmod 条目数 | 帮助搜索引擎判断重抓优先级 |
核心解析器代码如下(遍历 dist、跨页聚合、sitemap 对照的部分是常规的循环与正则,文末有获取完整脚本的方式):
import os, re
from html.parser import HTMLParser

DIST = r"C:\path\to\your\dist"
SITE = "https://your-domain.com"

class Page(HTMLParser):
    def __init__(self):
        super().__init__()
        self.title = ""; self._in_title = False
        self.meta_desc = None; self.canonical = None
        self.og_images = []; self.imgs = []; self.links = []
        self.h1 = 0; self.text_len = 0; self._skip = 0
    def handle_starttag(self, tag, attrs):
        a = dict(attrs)
        if tag == "title": self._in_title = True
        if tag in ("script", "style"): self._skip += 1   # 关键:排除 JS/CSS 文本
        if tag == "meta":
            if a.get("name") == "description": self.meta_desc = a.get("content", "")
            if a.get("property") == "og:image": self.og_images.append(a.get("content", ""))
        if tag == "link" and a.get("rel") == "canonical":
            self.canonical = a.get("href", "")
        if tag == "img": self.imgs.append((a.get("src", ""), a.get("alt")))
        if tag == "a" and a.get("href"): self.links.append(a["href"])
        if tag == "h1": self.h1 += 1
    def handle_endtag(self, tag):
        if tag == "title": self._in_title = False
        if tag in ("script", "style") and self._skip > 0: self._skip -= 1
    def handle_data(self, data):
        if self._in_title: self.title += data
        if self._skip == 0:
            self.text_len += len(re.sub(r"\s", "", data))
遍历 dist 下所有 .html,逐个 feed 给这个解析器,再做跨页面聚合(title/description 查重、内链死链检查、sitemap 对照)。运行方式:
python seo-check.py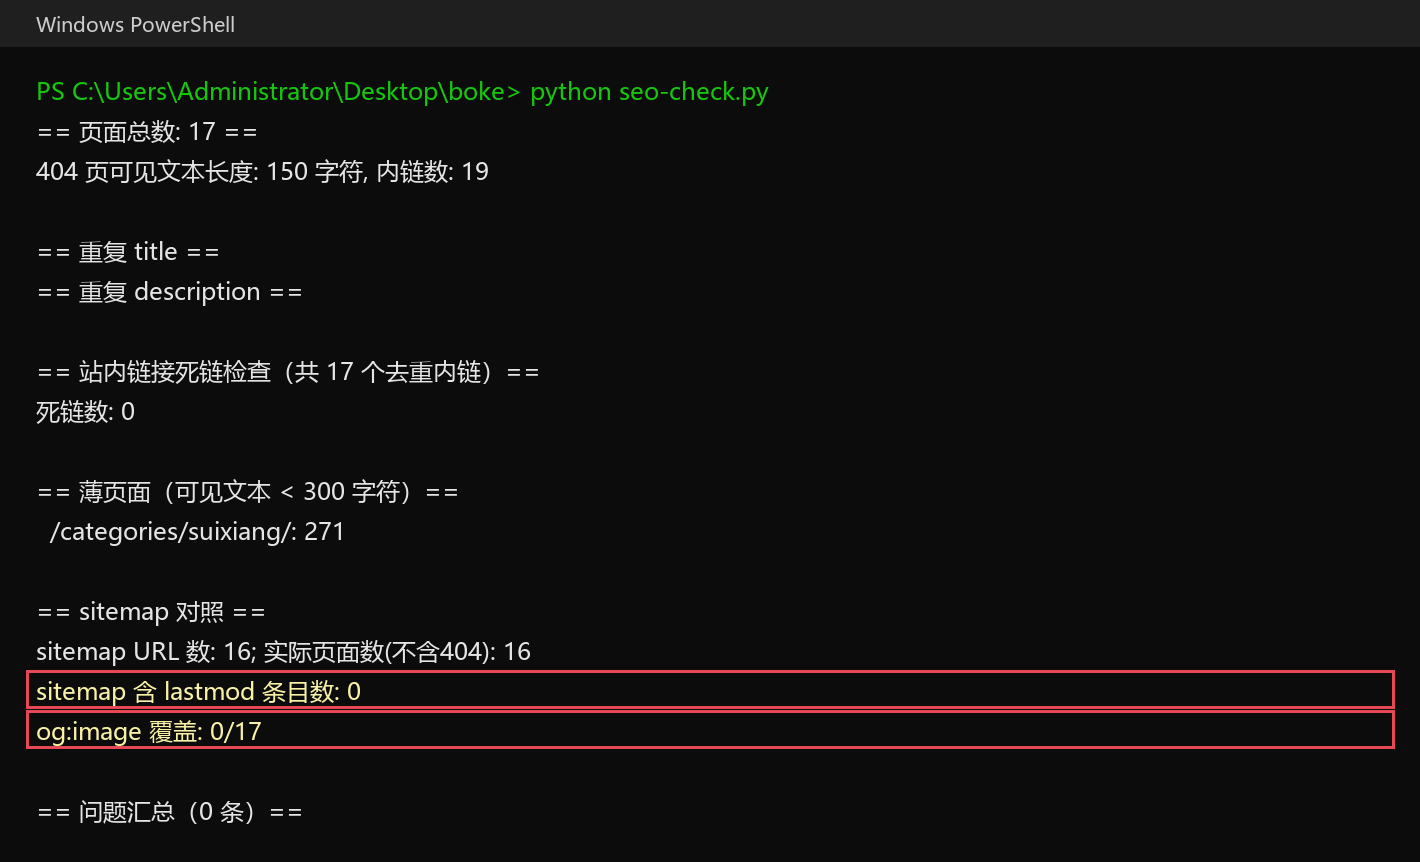
▲ 首次运行的输出。lastmod 条目数: 0 和 og:image 覆盖: 0/17 这两行,就是下文要修的两个问题。
三、先报平安:这些项目全绿
对 myybk.cn 当时的产物(17 个 HTML 页面)跑完,大部分项目是直接通过的,数据如下:
- title:17 页全部有 title,无重复,无超长;
- description:16 个正式页面全部有且互不重复(404 页不参与判定);
- canonical:全部存在,且统一指向
https://myybk.cn的尾斜杠规范形式; - h1:每个页面恰好 1 个;
- 图片:全部
<img>有非空 alt,引用的文件全部存在,零 404; - 内链:全站去重后 17 个站内链接,逐一映射回 dist 文件验证,死链数为 0;
- 404 页:可见文本 150 字符,带 19 个回站内链——简短说明 + 导航,符合预期;
- IndexNow key 文件:做了一次字节级复检,32 字节整,无 BOM、无末尾换行。这类 key 文件的内容必须和 key 一字节不差,编辑器自动加 BOM 或换行都会导致验证 403,用二进制方式读一遍才算真确认。
全绿的部分也值得写进报告——体检的价值不只是抓问题,也是把「应该没问题」变成「确认没问题」。
附:这些判定阈值是怎么定的
脚本里有几个数字是我拍脑袋拍的,但每个都有出处和取舍,说清楚免得照抄的人被误导:
- title ≤60 字符:Google 搜索结果标题大约显示 50~60 个字符(按像素截断,中文更短),超长的标题会被截成省略号。60 是一个偏宽松的上限,不是官方规定;
- 薄页面 <300 字符:这个阈值只用于「引起注意」,不用于「定罪」。落地页、联系页天生文字少,报出来是让人去看一眼是否合理(下文的分类页就是例子),而不是逼着给每个页面注水。真正要警惕的是文章页低于这个数;
- 404 页不参与 title/description/canonical 判定:404 页的任务是告诉别人「这里没有东西」并指个回路,拿正式页面的标准要求它没有意义;
- 死链检查只查站内绝对路径:外链(http/https 开头)应该在线上用带超时的 HEAD 请求查,本地离线脚本查不了,混在一起只会让报告不可读。外链检查是另一个话题,以后单独写。
四、问题一:sitemap 里一条 lastmod 都没有
现象
脚本的第 12 项检查输出:sitemap 含 lastmod 条目数: 0。
说实话看到这个数字我愣了一下——我一直想当然地认为 @astrojs/sitemap 会自动带上 lastmod,还把这个想当然写进过笔记。这正是「自我描述与实现不一致」的坑:你以为兑现了的承诺,产物里根本没有。 不跑这一遍,这个错误认知会一直带在身上。
为什么值得修
lastmod 不是收录的决定因素,但它是搜索引擎安排重抓优先级的参考信号。新站抓取配额本来就低,sitemap 里准确的 lastmod 能帮爬虫把配额花在真正更新过的页面上。翻了一下 @astrojs/sitemap(我装的 3.7.4)的行为:默认只输出 <loc>,lastmod 需要通过 serialize 钩子自己提供。
修复:从文章 frontmatter 里取真实日期
关键决策:只给有可信修改时间的页面加 lastmod,宁缺毋滥。 Google 官方说过,不准确的 lastmod 会被直接无视——把所有页面的 lastmod 都标成构建时间,等于告诉搜索引擎「我每天全站重写一遍」,这种信号没有价值。博客文章有 frontmatter 里的 pubDate/updatedDate,是可信的;首页、关于页没有可信时间,就不加。
在 astro.config.mjs 里加一个读取函数,配置加载时直接解析博客源文件的 frontmatter:
import fs from 'node:fs';
import path from 'node:path';

function collectBlogLastmods(siteUrl) {
  const dir = path.resolve('src/content/blog');
  const map = {};
  for (const f of fs.readdirSync(dir)) {
    if (!f.endsWith('.md')) continue;
    const raw = fs.readFileSync(path.join(dir, f), 'utf8');
    const updated = raw.match(/^updatedDate:\s*(.+)$/m)?.[1]?.trim();
    const pub = raw.match(/^pubDate:\s*(.+)$/m)?.[1]?.trim();
    const d = updated ?? pub;
    if (d) {
      map[`${siteUrl}/blog/${f.replace(/\.md$/, '')}/`] = new Date(d).toISOString();
    }
  }
  return map;
}

const siteUrl = 'https://myybk.cn';
const blogLastmods = collectBlogLastmods(siteUrl);

export default defineConfig({
  site: siteUrl,
  integrations: [
    sitemap({
      serialize(item) {
        if (blogLastmods[item.url]) item.lastmod = blogLastmods[item.url];
        return item;
      },
    }),
  ],
});重新构建后复检:lastmod 条目数 0 → 7,正好等于已发布的 7 篇文章,日期与 frontmatter 一致。其余 9 个页面保持不带 lastmod,这是刻意的,不是遗漏。
五、问题二:og:image 覆盖率 0/17
现象
脚本第 5 项检查的统计:17 个 HTML 页面,含 og:image 的页面数是 0。
检查布局组件后确认了原因:BaseLayout.astro 里 og:title、og:description、og:url、og:site_name、og:locale 一应俱全,唯独漏了 og:image。这就是典型的「配置了一多半」——单看 head 区域觉得 og 标签挺全,覆盖率统计一跑就现形。
为什么值得修
og:image 决定链接被分享到微信、X、Telegram 时有没有卡片图。没有它,文章被转发时就是一个干巴巴的灰块,点击率天差地别。另外从站点质量的角度:结构化标签写一半留一半,本身就是一种「没做完」的痕迹。
修复:先生成图,再补标签
OG 图的标准尺寸是 1200×630。我用 Pillow 写了个 30 行的小脚本生成默认分享图:站点配色的米白底、站名、一句话简介、域名,字体直接用系统自带的微软雅黑(C:/Windows/Fonts/msyhbd.ttc),输出到 public/images/og-default.png,成品 25KB。成品长这样:
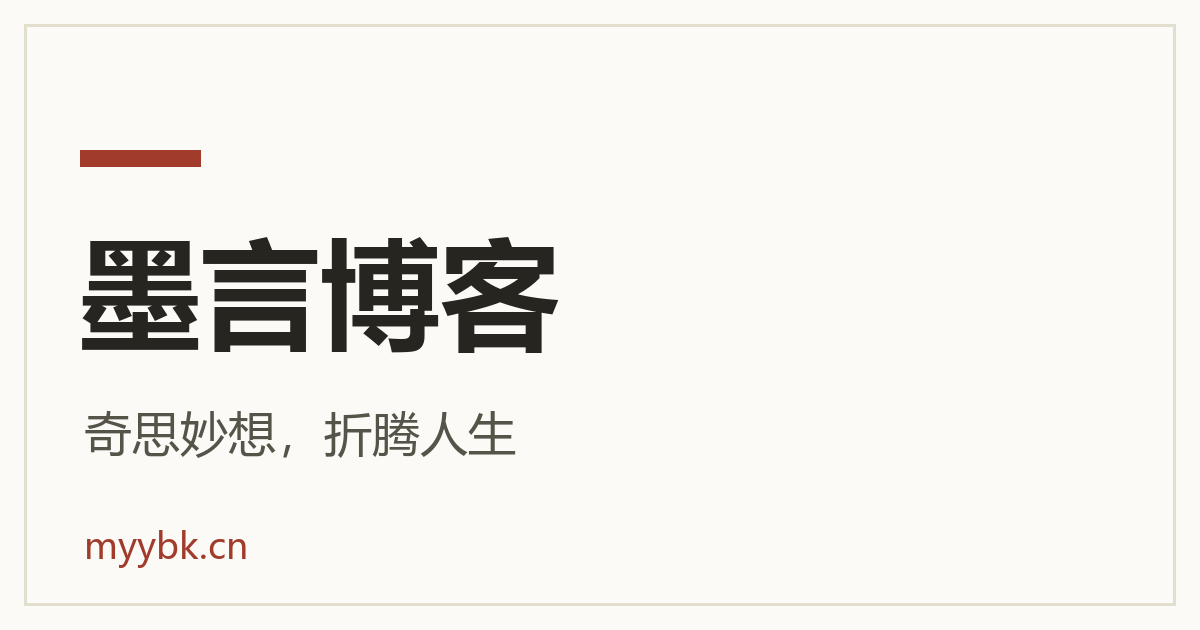
▲ 配色和网站视觉保持一致。
然后给 BaseLayout.astro 加一个 image 属性(默认值就是这张通用图,以后文章想配专属分享图可以逐篇传入),并在 head 里补上四行:
---
const { title, description, jsonLd, image = '/images/og-default.png' } = Astro.props;
const ogImage = new URL(image, SITE_URL).href;  // 必须拼成绝对 URL
---
<meta property="og:image" content={ogImage} />
<meta name="twitter:card" content="summary_large_image" />
<meta name="twitter:title" content={pageTitle} />
<meta name="twitter:image" content={ogImage} />一个容易忽略的细节:og:image 必须是绝对 URL,相对路径很多抓取器不认,所以用 new URL(image, SITE_URL).href 拼全。
重新构建后复检:覆盖率 0/17 → 17/17,且引用的图片文件真实存在(第 5 项检查同步确认,防止「标签加了但图 404」这种半吊子修复)。
六、一个「虚惊」:分类页只有 271 字符,改不改?
脚本第 9 项还报了一个观察项:/categories/suixiang/ 页面可见文本只有 271 字符,低于我设的 300 字符阈值。
分析后我决定不改,理由是分类落地页的性质就是「导航 + 文章卡片列表」,它的价值在结构而不在正文篇幅;这个分类下目前文章还少,文本自然短。等分类下文章多起来,这个数字会自己涨上去。
把它写进体检报告但不修,和没检查到是两回事——知道它薄、判断它合理、留下观察记录,这是体检和焦虑的区别。
七、写脚本时踩的三个坑
坑一:URL 到文件路径的映射没想象中简单。 Astro 的 build.format: 'directory' 模式下,/blog/xxx/ 对应 dist/blog/xxx/index.html,但 /favicon.ico 这类带扩展名的又直接对应文件,首页 / 对应 dist/index.html。映射函数必须分三种情况处理,还得兼容带不带尾斜杠两种写法,否则死链检查会报一堆假阳性。
坑二:不排空 script/style,正文统计全是水分。 第一版脚本的「正文长度」直接把 handle_data 收到的文本全算上,结果每个页面都「不薄」——因为页面里内联的 JS 全被算成了正文。加了一个 _skip 深度计数器,进入 <script>/<style> 就暂停计数,数字才回归真实。薄页面检查的准确性完全依赖这一步。
坑三:Windows 下 open() 不指定编码会当场去世。 Python 在 Windows 上默认按系统区域编码(GBK)读文件,读 UTF-8 的 HTML 直接 UnicodeDecodeError。所有 open() 必须显式 encoding='utf-8'。同理,正则匹配 frontmatter 时不能假设换行符是 \n 还是 \r\n,用 ^...$ 加 re.M 最稳。
八、修复前后对比
| 检查项 | 体检前 | 修复后 |
|---|---|---|
| sitemap lastmod 条目数 | 0 | 7(7 篇文章,真实发布日期) |
| og:image 覆盖率 | 0/17 | 17/17,文件存在 |
| twitter card 标签 | 无 | summary_large_image 全覆盖 |
| title/description 查重 | 通过 | 通过(未动) |
| 内链死链 | 0 | 0(未动) |
| 图片 alt / 404 | 通过 | 通过(未动) |
| 观察项:分类页 271 字符 | 记录,不改 | 持续观察 |
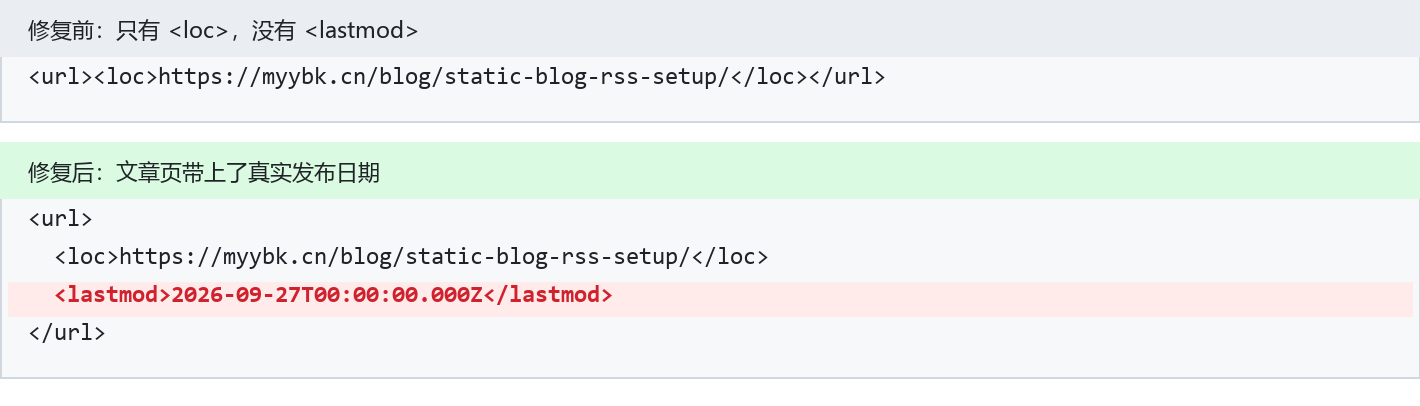
▲ 同一条 URL 在修复前后的 sitemap 条目(为可读性做了换行格式化,原文件为单行)。lastmod 取自文章 frontmatter 里的 pubDate/updatedDate。
九、收尾:把体检塞进发布流程
这次体检的两个修复加起来改了不到 40 行代码,但不跑脚本它们会一直藏在「以为没问题」里。我的下一步是把这个脚本挂到部署流程上:每次构建后、部署前跑一遍,报告出问题数非零就停下来看一眼——让「自我感觉良好」彻底退出发布链路。
对正在等新站收录的同路人,这也是这篇实录的最后一点价值:搜索引擎评估一个站时,看的不只是文章本身,还有这个站「像个认真维护的站」还是「像堆半成品」。技术健康度不直接等于内容质量,但它是所有内容被认真对待的背景板。og:image 批量指向不存在的图、sitemap 里的 URL 和实际页面对不上、正文里藏着一堆死链——这些问题单独看都不致命,但叠在一起就是「这个站没人认真管」的证据。反过来,一份全部通过、有数据、有日期的体检报告,是你对站点掌控力最直白的证明。
花一个下午写个体检脚本,比凭感觉补十处细节有用。毕竟修问题的前提是知道问题存在,而「知道」的唯一可靠方式,是把产物拉出来一项一项地数。
参考资料
- Google Search Central:Sitemap 协议与 lastmod 的说明
- Open Graph 协议官方文档
- @astrojs/sitemap 集成文档(serialize 配置)
- Python 标准库 html.parser 文档
文中所有数据来自 2026-09-30 对 myybk.cn 构建产物的实测。脚本在我的环境(Windows 11 + Python 3.13 + Astro 5)验证通过,改一下开头的 DIST 和 SITE 两个常量即可用于任何静态站。完整脚本如有需要可以通过联系页面索取。