2026 年了还给博客上 RSS:Astro 实现、自动发现和我的三个验证步骤
很多人觉得 RSS 是上古时代的玩意,但我的观察正相反:会用 RSS 阅读器的人,恰恰是阅读最深度、留存最久的那批读者。给博客加 RSS 的成本是半小时,收益是一个不受算法摆布的分发渠道——读者订阅了你,更新就一定送达,不需要搜索引擎收录、不需要平台推荐。myybk.cn 的 RSS 从实现到验证通过用了一个下午,过程记录如下。
实现:一个构建端点,二十行代码
Astro 官方有现成的 @astrojs/rss 包,配合构建端点(endpoint)就能在构建时生成 rss.xml。
import rss from '@astrojs/rss';
import { getCollection } from 'astro:content';
import { SITE_TITLE, SITE_DESCRIPTION, SITE_URL } from '../consts';

export async function GET(context) {
  const posts = (await getCollection('blog', ({ data }) => !data.draft))
    .sort((a, b) => b.data.pubDate.valueOf() - a.data.pubDate.valueOf());
  return rss({
    title: SITE_TITLE,
    description: SITE_DESCRIPTION,
    site: context.site ?? SITE_URL,
    items: posts.map((post) => ({
      title: post.data.title,
      description: post.data.description,
      pubDate: post.data.pubDate,
      link: `/blog/${post.id}/`,
    })),
    customData: '<language>zh-CN</language>',
  });
}
逐段说清这段代码里的四个决策:
过滤草稿(!data.draft)。 这是全站统一的口径:草稿不出现在列表页、搜索结果、sitemap,自然也不该出现在 RSS 里。漏掉这个过滤的话,没写完的文章会被推送到每一个订阅者的阅读器里,比出现在列表页更难堪。
按发布日期倒序。 RSS 阅读器按条目顺序展示,新的在前。
site 字段的兜底写法。 @astrojs/rss 要求知道站点的完整 URL 才能生成正确的绝对链接,它默认读 astro.config.mjs 里的 site 字段。没配的话构建直接报错——这是很多人卡的第一步。我这里写了 context.site ?? SITE_URL 双保险,配置漏了也能用常量兜住。
customData 声明语言。 中文博客加上 <language>zh-CN</language>,部分阅读器会用它做内容分类和字体渲染决策,一行成本,没理由不加。
别漏了自动发现:head 里的一行 link
生成 rss.xml 只完成了一半。让读者和阅读器「知道你有 RSS」,靠的是每个页面 <head> 里的自动发现标签:
<link rel="alternate" type="application/rss+xml" title="站点名" href="/rss.xml" />有这一行,Feedly、Inoreader 这类阅读器在输入博客地址时会自动探测到订阅源,用户不用手动找 rss.xml 的路径。我把它加在全站共用的 BaseLayout 里,一次配置全站生效。很多静态站教程只教你生成 feed 文件,不提这行标签——结果就是 RSS 存在但没人发现,等于没做。
验证:我的三个步骤
RSS 是 XML,格式错一个字符,阅读器就整个拒收,而且不会报任何明显的错。所以验证比实现更重要,我按顺序做三步:
第一步:浏览器直接打开 /rss.xml。 肉眼检查:每条 item 的标题、链接、日期是否齐全;链接点开是不是 404;草稿文有没有混进来。浏览器会把合法 XML 渲染成树状结构,如果看到白屏报错,说明 XML 本身就不合法,后面两步不用做了。
第二步:W3C Feed Validator 校验。 把 https://你的域名/rss.xml 提交到 validator.w3.org/feed,它会逐项检查格式问题。我第一次校验没过,原因是有一篇文章的 frontmatter 里 pubDate 写成了中文日期格式,@astrojs/rss 解析后产出了非法的日期字段——RSS 要求 RFC-822 格式日期。改成 ISO 格式(2026-09-21)后通过。这个坑的启示是:feed 的合法性取决于每一篇文章的元数据,加新文章时日期格式要统一。
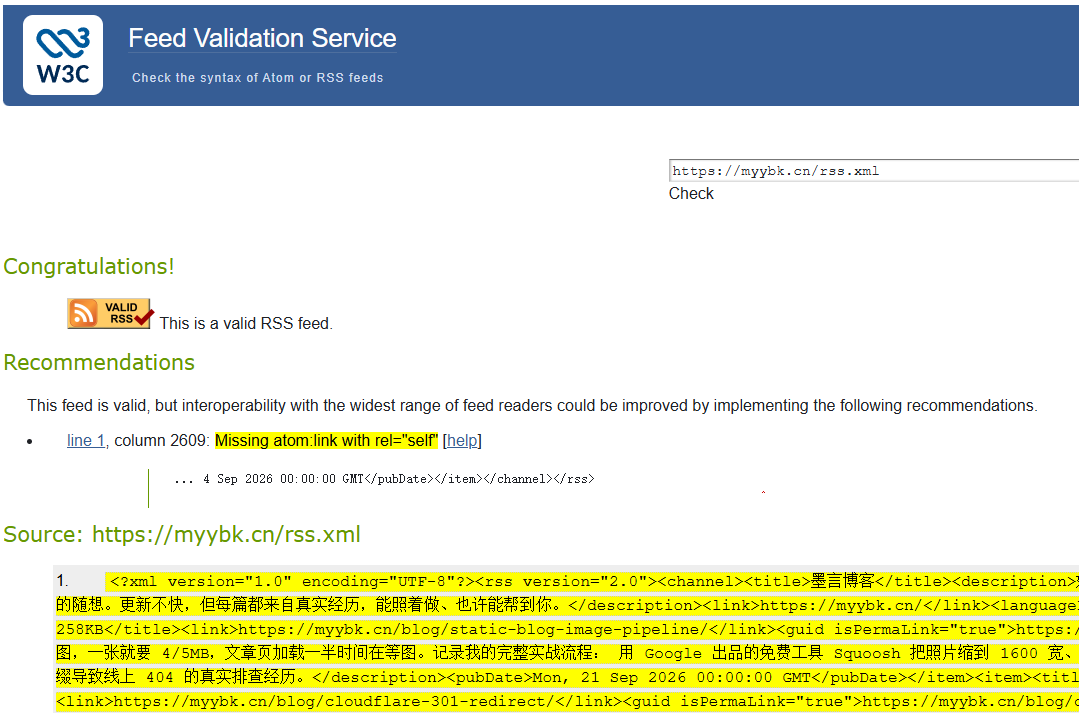
▲ W3C Feed Validator 校验通过的界面
第三步:用真实阅读器订阅自己。 校验器只保证格式合法,体验要自己试。我在 Fluent Reader 里订阅了自己的站,确认三件事:站点能不能被自动发现(这就是第二步那个 link 标签的作用);已发布文章的标题摘要显示是否正常;然后发一篇新文章,看阅读器多久抓到——我这边是构建部署后手动刷新 Fluent Reader 几乎是立马就抓到了。
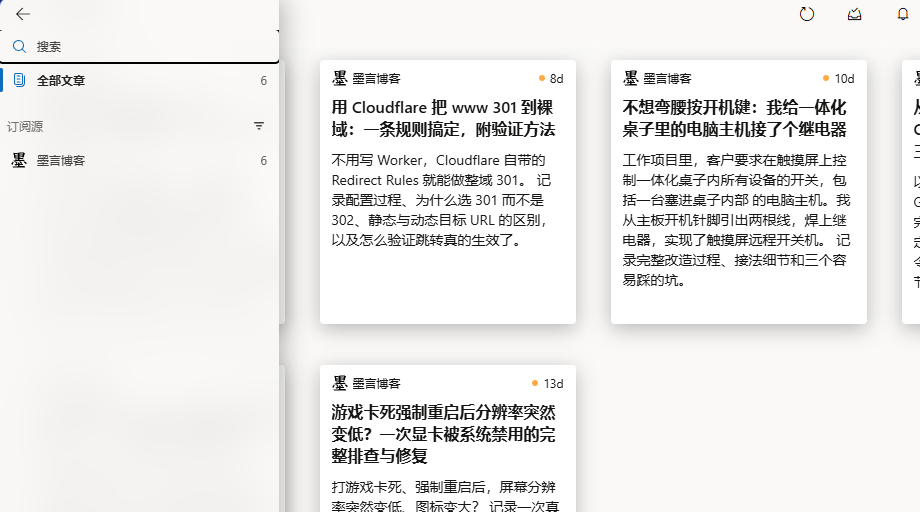
▲ Fluent Reader 界面
摘要还是全文:一个真实的取舍
@astrojs/rss 的 description 字段我放的是文章摘要(frontmatter 里的 description),不是正文全文。这个选择有争议,我的理由是:
全文输出对读者体验更好(阅读器里直接读完),但我的文章里有代码块、表格、图片占位符,Markdown 转 HTML 再塞进 RSS 的 content:encoded,各家阅读器渲染效果参差不齐,代码高亮全丢、表格错位的样子比「点回原文阅读」体验更差。摘要 + 原文链接是更稳的选择,顺带给网站带回访问量。
如果以后文章内容以纯文字为主,我会重新评估全文输出——这个决策和内容形态绑定,没有标准答案。
两个容易想错的地方
RSS 是轮询,不是推送。 阅读器不会在你发文那一刻收到通知,而是按自己的节奏定时抓取订阅源——快的几分钟,慢的几小时。所以「文章发出去订阅者立刻看到」是不现实的预期;反过来,前面验证第三步里「构建部署后手动刷新立刻抓到」是需要用户手动刷新才会立马抓取的。这个机制也塑造了 RSS 读者和公众号读者不同的心智:他们不求第一时间,求的是「不漏」。
feed 里的链接必须是绝对地址。 RSS 的阅读场景脱离你的网站——在阅读器里打开时,相对路径的链接和图片会全部失效。@astrojs/rss 会用 site 配置把条目链接拼成绝对 URL,这也是前面说「site 没配、构建直接报错」不能绕着走的原因。如果哪天改做全文输出,正文里相对路径的图片也要一并转成绝对地址,否则阅读器里全是裂图。
RSS 和 sitemap:给收录多开一条路
RSS 和 sitemap 对搜索引擎是互补关系:sitemap 告诉爬虫「全站有哪些页面」,RSS 告诉它「最近更新了什么」。一个可以直接落地的用法是:Bing Webmaster Tools 提交 sitemap 时,除了标准 XML 格式,还接受 RSS 2.0 和 Atom 格式——也就是说 rss.xml 本身就能作为 sitemap 提交给 Bing,对新站来说等于多了一条主动告知更新的通道。
总结
整个 RSS 功能的成本:一个 20 行的端点、一行 head 标签、半小时验证。它不会带来流量暴涨,但它服务的恰恰是最有价值的读者——主动订阅意味着「你的下一篇我一定看」。对一个打算长期写下去的博客,这种确定性比任何一次爆款都值钱。